
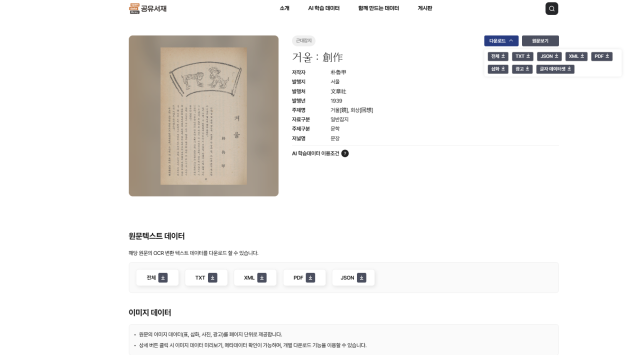
책, 표, 삽화, 광고, 사진 등 총 3800만건 이상의 데이터가 전 국민에게 공개된다.
국립중앙도서관은 국가문헌에서 구축한 인공지능(AI) 학습데이터를 처음으로 대국민 공개한다고 17일 밝혔다.
공개 대상은 텍스트 데이터(Hidden Text PDF, XML, TXT, JSON) 3974책(건), 표·삽화·광고·사진 등의 이미지 데이터 2만1485건, 메타데이터, 문자 단위의 글자 데이터셋 3830만건 등 총 3833만 건에 달한다.
개방 데이터는 국립중앙도서관 소장 디지털화 원문 중 저작권이 해결된 1930~40년대 근대잡지, 1940~60년대 정부간행물 및 교과서, 국립중앙도서관 발간자료와 인공지능(AI) 학습 이용 허락을 받은 오픈 액세스(Open Access, OA) 학술논문 등이다. 누구나 ‘공유서재’에서 자유롭게 열람하고 다운로드해 활용할 수 있다.
텍스트 데이터는 인공지능(AI)이 인식하기 쉽게 정제한 고품질 형태로 제공되어 연구와 서비스 개발에 곧바로 활용할 수 있다. 글자 데이터셋의 경우 다양한 형태의 문자 데이터를 인공지능(AI) 학습에 바로 활용할 수 있어, 대규모 데이터 확보에 어려움을 겪는 중소·벤처기업도 인공지능(AI) 기반 문자인식(OCR)·자연어 처리 등 관련 기술 개발에 폭넓게 이용할 수 있을 것으로 기대된다.
새 단장한 ‘공유서재’는 인공지능(AI)과 디지털 인문학 연구 지원, 공공데이터 활용 확장을 위한 기능도 함께 강화했다. 디지털로 축적된 방대한 지식자료를 인공지능(AI)이 학습할 수 있는 형태로 정리·가공함으로써, 기존에는 어려웠던 대규모 데이터 기반 인문학 연구도 가능해진다. 연구자들은 문헌·기록·이미지 등 다양한 자료를 인공지능(AI)으로 분석하고 새로운 의미를 도출하는 디지털 인문학 연구를 보다 쉽게 수행할 수 있을 것으로 기대된다.
또한 저작권 문제가 해결된 국가문헌을 AI 학습에 바로 활용할 수 있는 형태로 대규모 개방한다는 점에서 의미가 있다. 그동안 학습데이터 확보에 비용과 저작권 부담을 겪어온 연구자와 중소·벤처기업의 부담을 다소 완화할 것으로 기대된다.
플랫폼의 사용자 환경도 이용자 친화적으로 개선되었다. 직관적인 화면 구성과 자료 유형 및 이미지 유형별 탐색 구조를 적용하였으며, 별도의 가입 절차 없이 누구나 쉽게 데이터에 접근할 수 있어 전문 연구자뿐만 아니라 일반 이용자도 손쉽게 자료를 검색하고 활용할 수 있다.
국립중앙도서관은 올해 연말 한글 딱지본 소설 300여 책의 텍스트 데이터를 추가 개방하는 등 향후에도 데이터 구축과 개방을 지속 확대하고 인공지능(AI) 활용 서비스를 고도화하여, ‘공유서재’를 지속적으로 성장할 수 있는 데이터 플랫폼으로 발전시켜 나갈 계획이다.
이현주 국립중앙도서관 디지털정보기획과 과장은 “앞으로 데이터 개방 범위를 꾸준히 넓혀, 국민 누구나 공공 지식자원의 혜택을 누릴 수 있는 인공지능(AI) 시대의 도서관을 만들어가겠다”라고 밝혔다.
윤주혜 기자jujusun@ajunews.com
기자의 다른기사
©'5개국어 글로벌 경제신문' 아주경제. 무단전재·재배포 금지






