
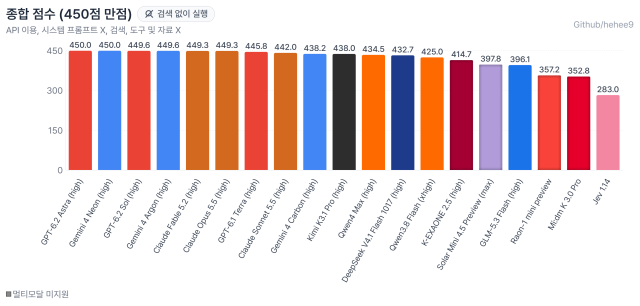
2027학년도 대학수학능력시험(수능)이 끝난 가운데 미국과 중국, 한국 등 주요 인공지능(AI) 모델에 수능 문제를 풀게 한 결과 오픈AI와 구글의 모델이 나란히 450점 만점을 기록했다.
과학기술정보통신부(과기정통부)가 추진하는 독자 AI 파운데이션 모델(독파모) 프로젝트에 참여하는 LG AI연구원과 업스테이지의 모델은 상대적으로 낮은 점수를 받았다. 특히 이미지가 포함된 문제에서 정답률이 크게 떨어지면서 글로벌 최상위 모델보다 멀티모달 성능이 뒤처지는 것으로 나타났다.
20일 순천향대학교 컴퓨터소프트웨어공학과 구유겸씨는 '2027년학년도 수능 거대언어모델(LLM) 풀이 대시보드'를 공개했다.
이 대시보드에 따르면 2027년 수능에서 만점을 기록한 모델은 오픈AI의 'GPT-6.2 아스트라(Astra)'와 구글의 '제미나이 4 네온(Neon)' 이었다.
앤트로픽 모델도 높은 성적을 보였다. '클로드 페이블 5.2'와 '클로드 오퍼스 5.5'도 각각 449.3점으로 집계됐다. 오픈AI의 'GPT 6.1 테라' 역시 445.8점을 기록했다.
중국 모델도 높은 점수를 기록했다. 중국 AI 기업 '키미'의 'K3.1프로'는 438점이었다. 키미는 국어, 영어, 한국사 영역에서 만점을 받았지만 수학과 탐구 영역에서 각각 96점과 92점을 받았다.
중국 알리바바그룹의 모델 '큐웬 4 맥스' 역시 국어, 영어, 한국사 영역에서 100점을 맞았다. 반면 수학과 탐구 영역에서 각각 96점과 88.5점을 기록했다.
반면 국내 AI 모델은 글로벌 최상위 모델과 점수 차이를 보였다. LG AI연구원의 'K-엑사원 2.5'는 총 414.7점으로 오픈AI 아스트라보다 35.3점 낮았다. 수학과 한국사 영역에서 만점을 기록했지만 국어 98점, 영어 96점, 탐구 영역에서는 70.7점에 그쳤다.
업스테이지의 '솔라 미니 4.5 프리뷰'는 397.8점을 기록해 만점 모델과 52.2점 차이가 났다. 한국사 영역에서만 만점을 받았으며 국어 91점, 수학 95,7점, 영어 96점, 탐구 영역 65.2점으로 집계됐다.
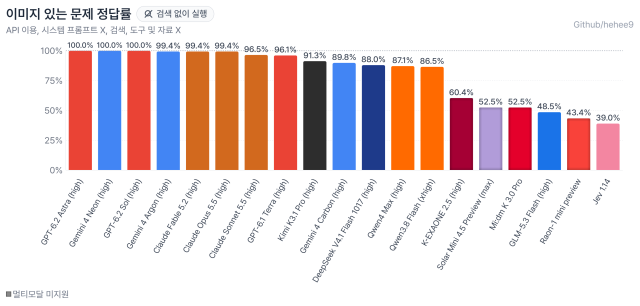
특히 국내 모델들은 이미지가 포함된 문제에서 낮은 정답률을 보였다. 이미지가 있는 문제의 정답률은 GPT-6.2 아스트라와 제미나이 4 네온, GPT-6.2 솔이 모두 100%를 기록했다. 클로드 페이블 5.2와 클로드 오퍼스 5.5도 각각 99.4%에 달했다.
이와 달리 K-엑사원 2.5의 이미지 포함 문제 정답률은 60.4%에 그쳤다. 솔라 미니 4.5 프리뷰는 52.5%로 집계됐다. 아스트라와 비교하면 각각 39.6%포인트(p), 47.5%p 낮은 수준이다.
전문가들은 이런 모델 성능 차이가 학습 데이터, 모델 규모, 추론 역량 등 복합적 요인에서 비롯됐다고 분석했다. 최병호 고려대학교 인공지능연구소 연구교수는 "글로벌 빅테크와 국내 기업 모델의 파라미터 규모와 추론 단계에서 활용할 수 있는 컴퓨팅 인프라 수준에서 차이가 크다"며 "이미지가 포함한 문제는 광학문자인식(OCR) 기술로 정보를 정확하게 추출한 후 추론하는 과정이 필요한데 빅테크의 경우 추론 모델 성능을 크게 높인 만큼 결과에서 차이가 날 수 밖에 없다"고 짚었다.
이어 "학습 데이터 차이도 중요한 요인"이라며 "글로벌 빅테크는 수능 기출문제, 문제집 등을 사전에 학습했을 가능성이 있지만 국내 기업들은 관련 데이터를 충분히 확보하지 못했을 수 도 있다"고 덧붙였다.
©'5개국어 글로벌 경제신문' 아주경제. 무단전재·재배포 금지






